En los artículos anteriores hemos visto cómo los agentes de IA pueden utilizar diferentes herramientas para resolver problemas. Aprendimos cómo pueden consultar bases de datos, utilizar APIs, buscar información en internet, ejecutar código con Python y procesar documentos como PDFs y manuales.
Hasta ahora, gran parte de nuestro enfoque ha estado relacionado con información escrita. El usuario realiza una pregunta, el agente analiza texto y posteriormente utiliza una herramienta para obtener información o realizar una acción.
Pero el mundo real no está compuesto solamente por texto.
Una cámara puede capturar una fotografía de una máquina. Un técnico puede enviar una imagen de un componente electrónico. Un usuario puede compartir una captura de pantalla de un error. Una empresa puede tener gráficas, fotografías, planos o documentos donde una parte importante de la información aparece de manera visual.
Aquí es donde aparecen los agentes multimodales.
Un agente multimodal es capaz de trabajar con diferentes tipos de información, como texto e imágenes, y utilizar esa información dentro de un mismo proceso para resolver una tarea.
1. ¿Qué significa que una IA sea multimodal?
La palabra "multimodal" hace referencia a la capacidad de trabajar con diferentes modalidades de información.
Una modalidad puede ser el texto.
Otra puede ser una imagen.
También podemos encontrar audio, video y otros tipos de información.
Un sistema que solamente procesa texto puede responder preguntas escritas, pero tendrá dificultades si recibe una fotografía y necesita interpretar lo que aparece en ella.
Un sistema multimodal puede analizar ambos tipos de información.
Por ejemplo, podemos mostrarle una fotografía de un circuito y preguntarle:
"¿Qué componentes puedes identificar en esta imagen?"
El sistema puede utilizar la información visual para generar una respuesta.
Esto amplía considerablemente las posibilidades de los agentes.
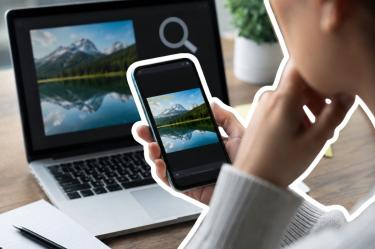
2. Texto e imágenes trabajando juntos
Una de las características más interesantes de los sistemas multimodales es que no necesariamente trabajan con una sola modalidad a la vez.
Podemos combinar texto e imagen.
Por ejemplo, un usuario puede enviar una fotografía de una placa electrónica y escribir:
"Este componente se está calentando demasiado. ¿Qué elementos puedes identificar y qué debería revisar?"
El agente tiene dos fuentes de información.
Por un lado, recibe la imagen.
Por otro, recibe la pregunta escrita.
Puede utilizar ambos elementos para interpretar la situación.
Esto es mucho más parecido a la manera en que una persona utiliza diferentes sentidos para analizar un problema.
3. Analizar fotografías
Una de las aplicaciones más sencillas consiste en analizar fotografías.
Por ejemplo, un agente puede recibir una fotografía de un objeto y describir algunos de sus elementos visibles.
En un entorno industrial, una imagen podría mostrar una máquina.
El usuario podría preguntar:
"¿Qué elementos visibles aparecen en esta fotografía?"
El agente puede identificar características visuales que sean reconocibles.
Sin embargo, es importante entender que identificar visualmente un objeto no significa necesariamente conocer su funcionamiento interno.
Una fotografía puede proporcionar información visual, pero no sustituye automáticamente a un manual técnico ni a una medición física.
4. Agentes que analizan capturas de pantalla
Las capturas de pantalla son otro caso de uso muy interesante.
Supongamos que un usuario recibe un mensaje de error en un programa y no sabe qué significa.
Puede realizar una captura de pantalla y enviarla al agente.
En lugar de copiar manualmente todo el texto del error, puede preguntar:
"¿Qué significa este error y qué debería revisar?"
El agente puede analizar la imagen, identificar el mensaje visible y explicar qué podría significar.
Para soporte técnico, esto puede resultar especialmente útil.
También puede aplicarse a aplicaciones empresariales, sistemas de automatización y herramientas de desarrollo.
5. Imágenes en ingeniería
En ingeniería, las imágenes pueden contener información importante.
Podemos encontrar fotografías de:
- componentes electrónicos
- máquinas
- instalaciones
- motores
- sensores
- conexiones
- instrumentos
- piezas mecánicas
Un agente multimodal puede ayudar a analizar este tipo de información.
Por ejemplo, un técnico podría fotografiar un componente y preguntar:
"¿Qué información visible aparece en la etiqueta?"
El agente podría leer el texto visible y organizarlo.
Después podría utilizar una herramienta de búsqueda para consultar información adicional.
Aquí podemos combinar varias capacidades.
Primero, el agente analiza la imagen.
Después utiliza la información obtenida para realizar una búsqueda.
Finalmente presenta los resultados al usuario.
6. OCR: convertir imágenes en texto
Cuando trabajamos con imágenes, una tecnología muy importante es el OCR, o reconocimiento óptico de caracteres.
El OCR permite detectar texto que aparece dentro de una imagen.
Por ejemplo, podemos tener una fotografía de una etiqueta:
"Motor X200 — 24 V — 5 A"
Un sistema de OCR puede convertir esa información visual en texto.
Después el agente puede utilizarla para realizar otras tareas.
Podría buscar el modelo en una base de datos, consultar un manual o realizar una búsqueda en internet.
De esta forma, la imagen se convierte en una fuente de información que puede alimentar al resto del sistema.
7. Leer documentos visualmente
En el artículo anterior hablamos sobre agentes que procesan documentos.
Ahora podemos ampliar esa capacidad.
Un documento puede contener texto, pero también tablas, imágenes y otros elementos visuales.
Un sistema multimodal puede analizar diferentes partes del documento.
Por ejemplo, un reporte puede contener una gráfica que muestra el comportamiento de una máquina durante una semana.
Un usuario podría preguntar:
"¿Qué tendencia muestra esta gráfica?"
El agente puede utilizar la información visual para proporcionar una explicación.
Esto es especialmente útil cuando la información no está expresada directamente como texto.
8. Analizar gráficas
Las gráficas son una forma de representar información.
Una persona puede observar una gráfica y rápidamente identificar si una variable está aumentando, disminuyendo o permaneciendo relativamente estable.
Los agentes multimodales pueden ayudar a interpretar este tipo de información.
Por ejemplo, una gráfica podría mostrar la temperatura de una máquina durante 24 horas.
El usuario puede preguntar:
"¿En qué momento se produjo el aumento más importante de temperatura?"
El agente puede analizar la representación visual y señalar el comportamiento observado.
Sin embargo, cuando se necesitan valores numéricos exactos, es preferible proporcionar los datos originales siempre que sea posible.
Una imagen de una gráfica puede ser suficiente para comprender una tendencia, pero una tabla con los valores permite realizar cálculos con mucha mayor precisión.
9. Reconocer patrones visuales
Otra aplicación consiste en detectar patrones.
Por ejemplo, una imagen podría mostrar varias piezas y el usuario podría preguntar:
"¿Cuáles parecen diferentes del resto?"
Un agente puede analizar características visuales y señalar diferencias.
Esto puede ser útil para inspecciones, clasificación y revisión de imágenes.
Pero debemos distinguir entre detectar una diferencia visual y determinar que una pieza está defectuosa.
Una diferencia puede deberse a iluminación, perspectiva, suciedad o variaciones normales de fabricación.
Por eso, en sistemas industriales críticos se deben utilizar métodos de inspección adecuados y no depender exclusivamente de una respuesta generada por IA.
10. Agentes multimodales en mantenimiento
El mantenimiento es un área donde esta tecnología puede resultar especialmente interesante.
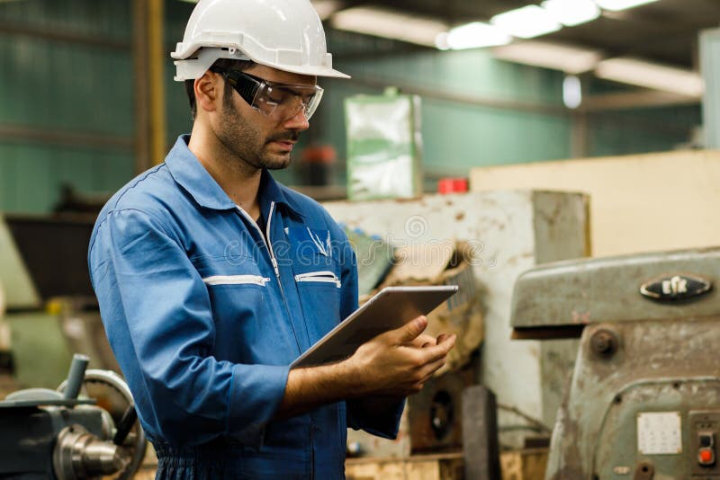
Imaginemos que un técnico encuentra una situación inesperada en una máquina.
Puede tomar una fotografía y enviarla a un agente.
El agente puede analizar los elementos visibles y, utilizando otras herramientas, consultar documentación relacionada.
Por ejemplo:
- El técnico toma una fotografía.
- El agente identifica información visible.
- Consulta el manual correspondiente.
- Busca el código o componente relacionado.
- Presenta posibles pasos de revisión.
- El técnico verifica físicamente la situación.
Aquí podemos ver nuevamente el patrón que hemos construido durante la serie.
El agente no utiliza solamente un modelo de IA.
Combina percepción, información externa y herramientas.
11. La IA puede ver, pero no significa que tenga acceso a todo
Es importante evitar una interpretación equivocada.
Decir que un modelo puede analizar imágenes no significa que tenga una percepción perfecta del mundo.
Una imagen puede estar borrosa.
Puede tener poca iluminación.
Puede mostrar solamente una parte del objeto.
Puede existir un ángulo que oculte información importante.
También puede haber elementos que visualmente sean muy parecidos.
Por eso, las respuestas deben interpretarse de acuerdo con la calidad de la información disponible.
Si una fotografía no permite distinguir claramente un componente, el agente debería reconocer esa limitación en lugar de afirmar algo con certeza.
12. Calidad de la imagen
La calidad de la información de entrada tiene un impacto importante.
Una fotografía desenfocada puede dificultar la lectura de una etiqueta.
Una imagen demasiado oscura puede ocultar detalles.
Una fotografía tomada desde muy lejos puede no mostrar suficiente información.
Por eso, cuando se diseñan sistemas multimodales, también se debe considerar cómo se capturarán las imágenes.
En una aplicación real, puede ser necesario establecer requisitos mínimos de resolución, iluminación y posición.
La inteligencia artificial puede analizar una imagen, pero no puede recuperar información que nunca fue capturada correctamente.
13. Agentes que combinan visión y herramientas
La verdadera utilidad aparece cuando el análisis visual se combina con otras herramientas.
Imaginemos un agente utilizado para identificar componentes electrónicos.
El usuario proporciona una fotografía.
El agente obtiene información visual.
Después utiliza una API o una base de datos para buscar el componente.
Finalmente puede recuperar especificaciones técnicas.
El resultado podría ser:
"El componente parece corresponder al modelo X. La base de datos indica que trabaja con una alimentación de 5 V y tiene una corriente máxima determinada. Para confirmar el modelo, es necesario revisar la referencia impresa en la pieza."
Este ejemplo demuestra algo importante: la imagen puede ser solamente el primer paso de un proceso mucho más grande.
14. Imágenes y búsqueda web
También podemos combinar visión con búsqueda en internet.
Por ejemplo, un usuario podría proporcionar una fotografía de un dispositivo y preguntar:
"¿Qué tipo de dispositivo es y dónde puedo encontrar su manual?"
El agente puede analizar la imagen para obtener información como marca, modelo o texto visible.
Después puede realizar una búsqueda web.
Finalmente puede presentar los resultados.
Esto convierte al agente en una especie de asistente de investigación visual.
Sin embargo, las búsquedas deben realizarse con cuidado, especialmente cuando existen modelos muy parecidos.
15. Imágenes y bases de datos
Otra posibilidad consiste en combinar visión con bases de datos.
Imaginemos una empresa que tiene un inventario de componentes.
Un trabajador encuentra una pieza sin identificar.
Toma una fotografía y la proporciona al agente.
El agente puede analizar las características visibles y utilizar información obtenida de la imagen para buscar coincidencias dentro de la base de datos.
Si encuentra varias opciones, puede solicitar información adicional.
Por ejemplo:
"Hay tres componentes similares. Necesito que me proporciones una fotografía de la etiqueta lateral para distinguirlos."
Esto demuestra una característica interesante de los agentes: pueden utilizar la información obtenida durante un paso para decidir qué necesitan después.
16. Agentes multimodales para soporte técnico
El soporte técnico es otro campo con muchas posibilidades.
En lugar de explicar un problema únicamente mediante texto, el usuario puede enviar una fotografía o captura de pantalla.
El agente puede analizarla y utilizar documentación para proporcionar una orientación inicial.
Por ejemplo:
"Mi aplicación muestra este mensaje."
El usuario adjunta una captura.
El agente identifica el error y puede consultar una base de conocimiento.
Después responde:
"El mensaje indica un problema de conexión. Revisa primero que el dispositivo esté conectado a la red y después verifica la configuración indicada en el manual."
Esto puede reducir el tiempo necesario para diagnosticar problemas sencillos.
17. Video y agentes multimodales
La multimodalidad también puede extenderse al video.
Un video contiene una secuencia de imágenes a lo largo del tiempo.
Esto permite analizar acciones y cambios.
Por ejemplo, una cámara podría grabar una máquina y un sistema podría analizar determinados eventos.
Sin embargo, procesar video puede requerir muchos más recursos que procesar una sola imagen.
Además, interpretar correctamente una secuencia temporal puede ser más complejo.
Por eso, en una aplicación real puede ser conveniente seleccionar solamente los momentos importantes del video en lugar de analizar absolutamente cada cuadro.
18. Audio y voz
La multimodalidad también puede incluir audio.
Un agente puede recibir una instrucción mediante voz, convertirla en texto y posteriormente utilizar herramientas.
Por ejemplo, un operador podría decir:
"Consulta la temperatura de la máquina tres."
El sistema puede interpretar la instrucción, consultar una base de datos de sensores y responder.
También puede combinar voz con imágenes.
Un técnico podría tomar una fotografía y explicar verbalmente:
"Este componente comenzó a calentarse después de cambiar la fuente de alimentación."
El agente tendría información visual y textual para analizar el problema.
Esto abre la puerta a interfaces mucho más naturales.
19. Un agente multimodal completo
Podemos imaginar un agente con varias capacidades:
Recibe texto.
Analiza imágenes.
Procesa documentos.
Consulta bases de datos.
Busca información en internet.
Utiliza APIs.
Ejecuta código.
Guarda información en memoria.
La diferencia es que ahora todas estas capacidades pueden formar parte de un mismo flujo de trabajo.
Por ejemplo, un técnico podría proporcionar una fotografía de un equipo.
El agente identifica el modelo.
Busca el manual.
Consulta el historial del dispositivo en una base de datos.
Analiza los últimos registros de sensores.
Después presenta posibles causas del problema.
Finalmente, si el sistema tiene los permisos necesarios, podría generar una orden de mantenimiento.
Esto ya se parece mucho más a un asistente técnico inteligente que a un chatbot tradicional.
20. ¿Qué es computer vision?
Un concepto relacionado con los agentes multimodales es computer vision, o visión por computadora.
La visión por computadora es el campo dedicado a desarrollar sistemas capaces de procesar e interpretar información visual.
Durante muchos años se ha utilizado en aplicaciones como reconocimiento de objetos, inspección industrial, análisis de imágenes y automatización.
Los modelos multimodales actuales amplían estas capacidades al permitir relacionar la información visual con lenguaje natural.
Por ejemplo, no solamente podemos detectar que existe un objeto en una imagen, sino también hacer preguntas sobre él utilizando lenguaje.
Esto facilita la creación de interfaces más flexibles.
21. Visión por computadora tradicional frente a modelos multimodales
Ambos enfoques pueden ser útiles, pero tienen diferencias.
Un sistema tradicional de visión por computadora puede estar diseñado específicamente para una tarea.
Por ejemplo:
"Detectar si una pieza tiene un agujero."
Un modelo multimodal puede ser más flexible.
Podemos preguntarle:
"¿Qué observas en esta pieza?"
o:
"¿Hay algo diferente entre estas dos fotografías?"
La flexibilidad es una ventaja, pero no significa que siempre sea la mejor opción.
En aplicaciones industriales muy específicas, un sistema especializado puede ofrecer mayor precisión y comportamiento más predecible.
Por eso, la tecnología debe elegirse de acuerdo con el problema.
22. El problema de las alucinaciones visuales
Al igual que ocurre con el texto, los modelos multimodales pueden cometer errores.
Pueden interpretar incorrectamente una imagen o afirmar que existe un elemento que realmente no está presente.
Por eso, no debemos considerar una respuesta visual como una medición absoluta.
Si necesitamos conocer una dimensión exacta, puede ser mejor utilizar un instrumento de medición.
Si necesitamos conocer la temperatura exacta de una máquina, debemos consultar un sensor.
La IA puede interpretar información, pero no sustituye automáticamente a los instrumentos especializados.
23. Cuándo utilizar un agente multimodal
Los agentes multimodales son especialmente interesantes cuando la información necesaria para resolver una tarea está distribuida entre diferentes formatos.
Por ejemplo:
Una fotografía muestra el problema.
Un manual explica el procedimiento.
Una base de datos contiene el historial.
Un sensor proporciona datos actuales.
Una API permite ejecutar una acción.
El agente puede coordinar toda esa información.
En cambio, si una tarea solamente requiere consultar una tabla estructurada, quizá no sea necesario utilizar capacidades visuales.
Una buena arquitectura utiliza solamente las capacidades que realmente necesita.
24. Un ejemplo completo en automatización
Imaginemos una línea de producción.
Una cámara toma fotografías de los productos fabricados.
Un agente recibe una imagen de una pieza.
El sistema analiza visualmente el producto.
Si detecta una característica que requiere revisión, consulta la información del producto en una base de datos.
Después puede consultar los criterios de calidad almacenados en documentación.
Finalmente genera un reporte.
Si el sistema está correctamente diseñado, podría incluso enviar una alerta al responsable correspondiente.
Aquí tenemos una combinación de:
Visión.
Documentos.
Base de datos.
Reglas.
Agente de IA.
Herramientas.
Notificaciones.
La IA no realiza necesariamente todas las tareas por sí sola. Su función principal puede ser coordinar la información y decidir qué herramientas utilizar.
25. Seguridad en sistemas multimodales
Los sistemas que procesan imágenes también requieren medidas de seguridad.
Una fotografía puede contener información privada.
Por ejemplo, una captura de pantalla podría mostrar datos personales.
Una fotografía tomada dentro de una empresa podría revelar información confidencial.
Por eso, es importante establecer qué imágenes pueden procesarse, quién puede acceder a ellas y cuánto tiempo se almacenan.
También debemos considerar que una imagen puede contener información que el usuario no esperaba compartir.
Por ejemplo, una fotografía de un escritorio puede mostrar documentos, contraseñas escritas o información interna.
Antes de utilizar un agente multimodal en una empresa, es importante analizar estas situaciones.
26. El futuro de los agentes multimodales
La multimodalidad probablemente será una de las características más importantes de los agentes de IA.
Los agentes no tendrán que limitarse a leer mensajes.
Podrán recibir texto, imágenes, documentos, audio y posiblemente video como parte de una misma tarea.
Esto permitirá construir asistentes más cercanos a la forma en que las personas trabajan.
Un técnico podrá mostrar un problema.
Un ingeniero podrá proporcionar una gráfica.
Un estudiante podrá compartir una fotografía de un circuito.
Un usuario podrá enviar una captura de pantalla.
El agente podrá analizar la información y utilizar herramientas para continuar con el proceso.
La verdadera innovación no está únicamente en que la IA pueda "ver", sino en que pueda usar lo que ve para decidir qué hacer después.
Conclusiones
Los agentes multimodales amplían las capacidades de la inteligencia artificial al permitir trabajar con información visual además del texto. Pueden analizar fotografías, capturas de pantalla, gráficas, documentos e imágenes, y utilizar esa información como parte de tareas más complejas.
Sin embargo, es importante conocer sus limitaciones. La calidad de la imagen, la falta de contexto y los posibles errores de interpretación pueden afectar los resultados. En aplicaciones críticas, la IA debe utilizarse como una herramienta de apoyo y combinarse con datos confiables, instrumentos especializados y supervisión humana.
La verdadera potencia aparece cuando la visión se combina con otras herramientas. Un agente puede analizar una fotografía, consultar una base de datos, buscar un manual, ejecutar código y utilizar una API para completar una tarea.
En el siguiente artículo hablaremos precisamente de una tecnología fundamental para conseguir que los agentes puedan recordar información de manera persistente mediante bases de datos vectoriales, y veremos cómo convertir la memoria de un agente en una herramienta mucho más potente.